API 站被彻底关闭之后
摘要
一次 API 站被网安要求彻底关闭的经历。抓取是否合规、有没有留痕、内容怎么证明,哪些地方最容易想当然。
API 站被彻底关闭之后
对方说得很客气,语气不重,要求很清楚:站彻底关,解析也删。
理由不复杂:网站涉及 AI,AI 属于监管重点,怕出问题。电话里没有让写保证书,也没有让交情况说明,只要求彻底关闭,域名解析也要删掉。
站不大,日调用量最高的时候也就几千次。服务器还在按时续费,域名也没有到期。关站那天,后台的调用曲线从几排小尖峰变成了一条平线。
程序是我用 AI 写的。它省了写路由、写解析的时间,没省掉“这些数据能不能用”。站一关,这一步也省了。
我争了几句。对方没打断,也没不耐烦,耐心把同样的话又说了一遍。可聊来聊去,还是绕不开那三个问题:抓取合不合规、有没有留痕、怎么证明内容没问题。
1. 事情经过
站点做的是数据查询接口:把公开接口和网页上的信息整理成 JSON,按关键词返回。程序代码在 bocmiao/api,129 个接口的清单、数据源说明和部署方式都在里面。仓库里是代码,线上运行数据不跟着仓库走。
站点有账号体系,但大部分接口不需要登录;后台存了邮箱、Key 和调用记录,没有存身份证这类字段。
接到电话后,我按要求关了站。对方说得很简洁:不是停一停,是彻底关闭,域名解析也要删掉。
我问过具体是哪一类数据、哪一条规定、什么范围。答复是先把站关了。后来我没再问依据,开始问怎么关。
后来我把代码和数据翻出来,从头看了一遍。有些地方,确实说不清。
2. “AI 抓取”和三个问题
“AI 抓取”不是法律术语,更像一个口头标签。站里确实有 AI 接口,后台也用了 AI 分析接口失败原因;但电话里说的“涉及 AI”,具体指模型、训练数据、抓取方式,还是 AI 生成的内容,没有细分。
我后来把这件事拆成三个问题。问了一圈,也没有拿到能逐条对照的答案。
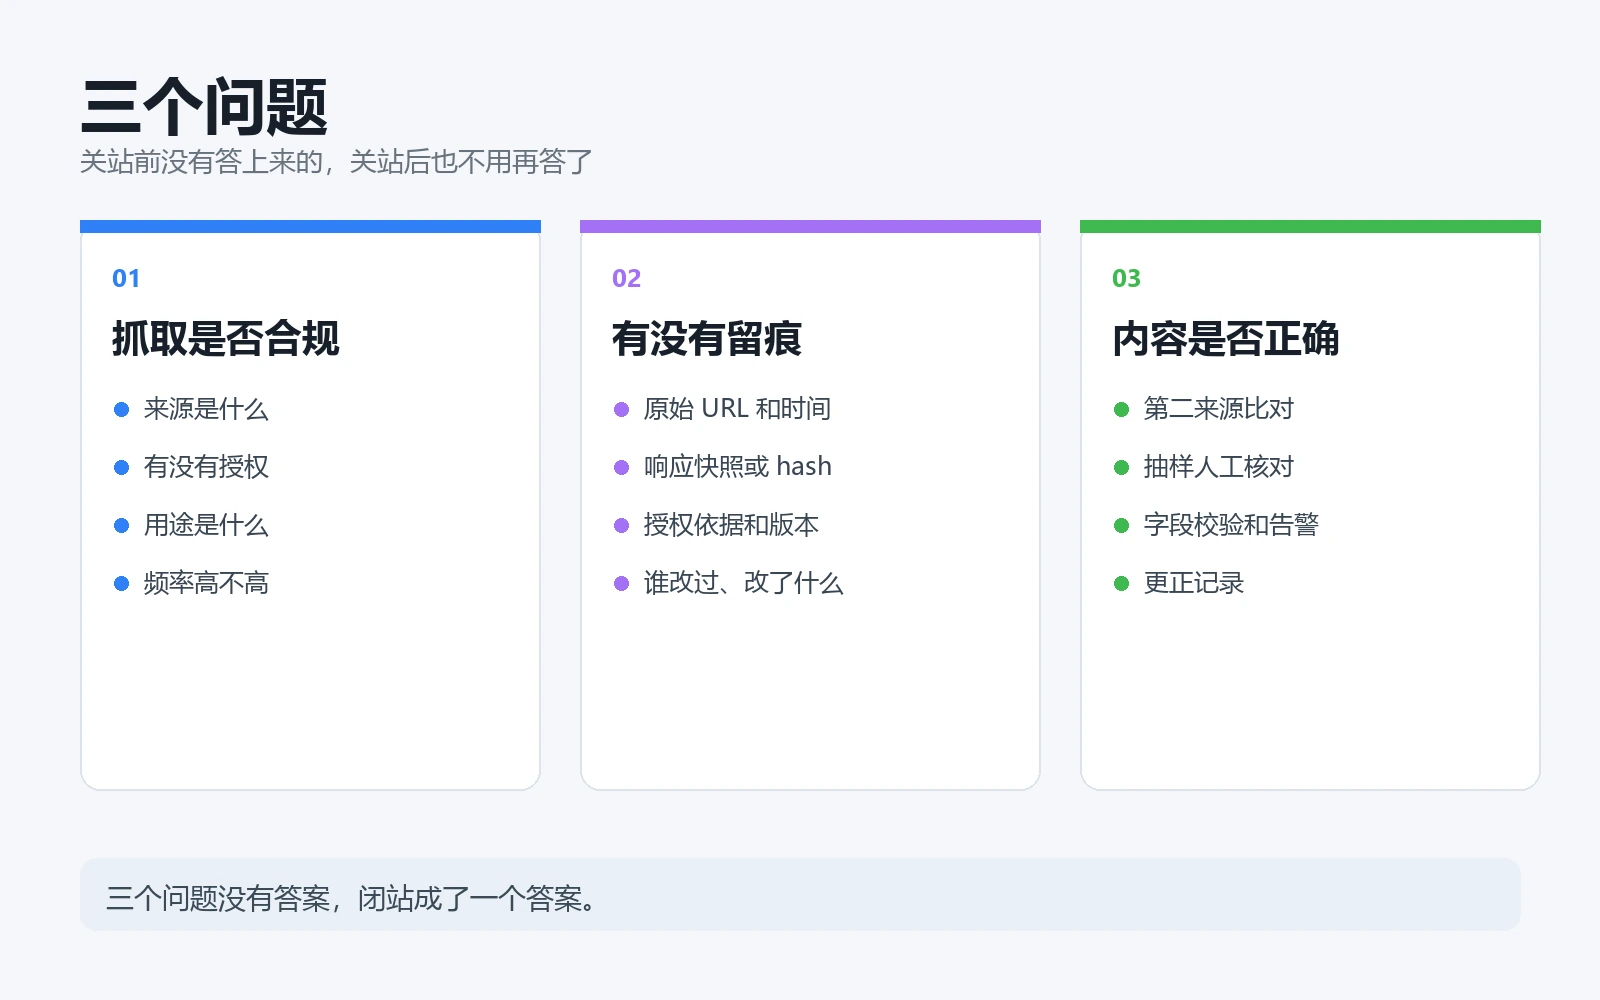
三个问题:抓取是否合规、有没有留痕、内容是否正确。
2.1 抓取是否合规
先看来源,不看模型。
来源不止一种:公开页面、登录后的内容、付费内容、别人接口返回的数据。边界不一样,得分开看。
接口有没有授权,要看合同、邮件、API Key 申请记录。用途也要看:做检索、做展示、做训练、做转售,不是一回事。请求频率太高,把对方服务拖慢,也是另一层问题。
模型不会让不合规的抓取变合规。AI 只是工具,抓取是行为。
2.2 有没有留痕
合规之后,还要能查证。
如果项目还在跑,至少要能拿出这些记录:原始 URL、抓取时间、HTTP 状态、响应快照或 hash、请求参数、User-Agent、授权依据和条款版本。数据进系统以后,字段怎么映射、谁改过、什么时候改的,也单独记。这次关站,我只能把已有日志翻出来,缺的部分补不了。
AI 参与摘要、分类或生成的话,也应该留下模型、prompt、输入、输出和人工复核记录。
只存结果,不存来源,等于没法查证。别人问“这条数据哪来的”,只能回答“程序抓的”,这句话没有用。
授权也一样。关站后,我翻邮件、聊天记录、后台截图,想证明某些数据有授权。能拿出来的,只有几句“应该可以”和“我看别人也这么干”。
这些话在技术群里能过关,在正式问询里过不了。授权最好是书面的:合同、邮件、后台条款截图、API 申请记录、对方明确的回复。没有书面记录,至少把来源 URL、抓取时间、条款版本存下来。
别等出事再补。补出来的东西,自己都不信。
2.3 怎么证明内容是对的
单一来源不等于正确。正确和合规也是两条线:内容对,不代表来源和用途合规;来源合规,也不代表字段没有错。
如果还要上线,我会在上线前做这些:源站和第二来源比对,按比例抽样人工核对,字段做类型和范围校验,出现异常就告警;发现错误,保留更正记录,不悄悄改掉。
AI 生成的内容要能回到原文。回不去的,就不应该当成事实发出去。
所谓正确,得能复现、能对照、能更正,不是看着像。
3. 公开网页不等于可以随便用
我当初的判断很简单:页面没有登录,浏览器能打开,那就是公开的。
别人能看,只说明页面没上锁;能不能批量拿走、转存、再分发,是另一回事。
网站的 robots.txt、用户协议、API 条款、数据库权利、图片版权,各管一段。有些站允许人看,不允许机器抓;有些允许搜索引擎抓,不允许第三方做镜像;有些允许非商业使用,不允许卖接口。
请求成功只说明服务器回了 200,不说明你有资格把结果再卖一遍。
具体边界以当地法律、网站条款和授权为准,这段话不能当法律意见。但浏览器能打开,不等于我可以拿它做生意。
4. API 站和爬虫,问题会叠加
爬虫是采集,API 站是分发。
采集的时候没解决授权,分发的时候会把问题放大。一个页面被一个人看,和一个页面被接口返回给一千个调用方,性质不一样。
我做的是后者。写代码时,我想的是并发、缓存、限流、错误重试;没想过“这些数据凭什么由我来提供”。
这句话不好听,但确实是关站那天最该问的。
5. AI 写的代码,签字的是人
程序大部分是 AI 写的。它写路由、写解析、写缓存,写得比我快。生成的注释也很整齐,整齐到让我误以为事情已经想清楚了。
但 AI 不会接这个电话,也不会去说明数据来源。
我用 AI 省了写代码的时间,却没有省掉确认数据来源的时间。后来有人问我,AI 写的程序出了问题是不是 AI 负责。我说,AI 只负责生成,不负责签字。
如果重来一次,我会把生成记录、修改记录、数据来源说明都留好。至少能说清楚哪部分是生成的,哪部分是我改的,哪部分是我当时没想明白的。
6. 个人信息和开放入口
接口大多不需要登录,但我抓的页面里有用户名、头像、简介,有些还有联系方式。
这些字段在页面上是公开的,聚合起来就可能变成另一回事。
我当时觉得,没有存手机号就不算个人信息。这个判断太粗。
如果项目还在跑,我会把用户名、头像、简介、IP、UA 单独列出来,能删的删,能脱敏的脱敏。要是站点有用户提交,哪怕只是一个留言框,也要按“会收到个人信息”来设计。
网安同时要求博客不能开放交互式功能,评论区不能开。
我一开始只盯着 API 站,觉得博客是另一回事。后来把“交互式”三个字拆开看,评论、留言、投稿、登录后互动,都是入口。入口开着,就要有人管;没人管,关掉最省事。
博客只留文章阅读。评论、投稿和需要登录的互动都关掉了。页面安静了不少。
7. “怎么整改”
我问过怎么整改。
答复是:闭站。
我问过不止一次:整改之后还能不能继续运营。答复都一样:闭站,不能再开。
不是先停一停,是彻底关,解析也删。所谓整改,就是把我这个变量从系统里删掉。
我问,能不能指出哪里不合规,我照着改。答复是:你先证明你抓的信息没问题。
再问,还是这句话。
我问证明的标准是什么,没拿到。问整改的范围,没拿到。问整改之后能不能恢复,也没拿到。
最后我把站关了,解析也删了。没有整改动作,也没有恢复流程。
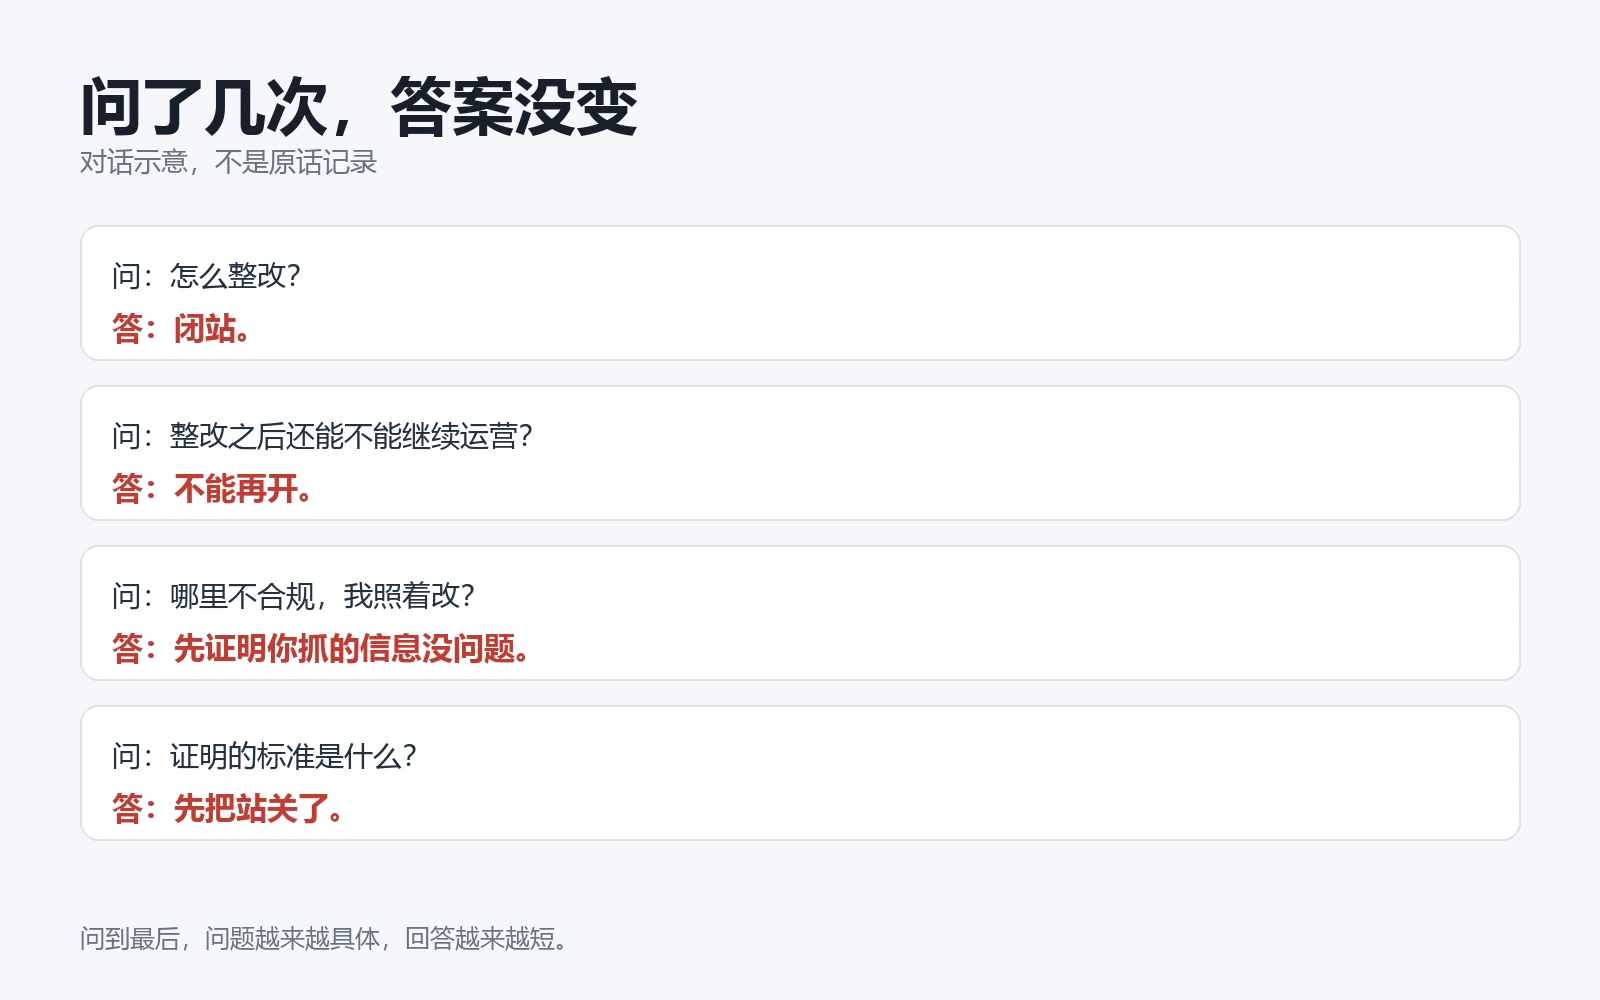
对话示意:问了几次,答案没有变。
8. 彻底关掉之后
关站之后,我做的只是收尾:保留日志,整理数据来源表,把代码和数据分开。这些不是整改,是善后。服务器账单、域名续费提醒、调用日志被我放进同一个文件夹,像给一个已经下线的项目做复盘。
没有保证书,没有情况说明,也没有下一步。站关了,解析删了,事情就结束了。
没有删库,没有清日志,也没有把责任推给 AI。
我自己列了一份清单,把每个数据源、每个字段、每个调用方都过了一遍。列完发现,最说不清的地方,恰好是当初觉得“应该没问题”的地方。
电话里没有条文,我的清单写了好几页。页数不对等,但流程就是这样。
服务停了,解析还在,等于门口还挂着牌子。删解析这一步,比停服务更像真的结束。
如果遇到类似情况,先找律师,再问清楚依据和范围;能书面就书面。技术上的问题有日志,合规上的问题,有时只有一句话。
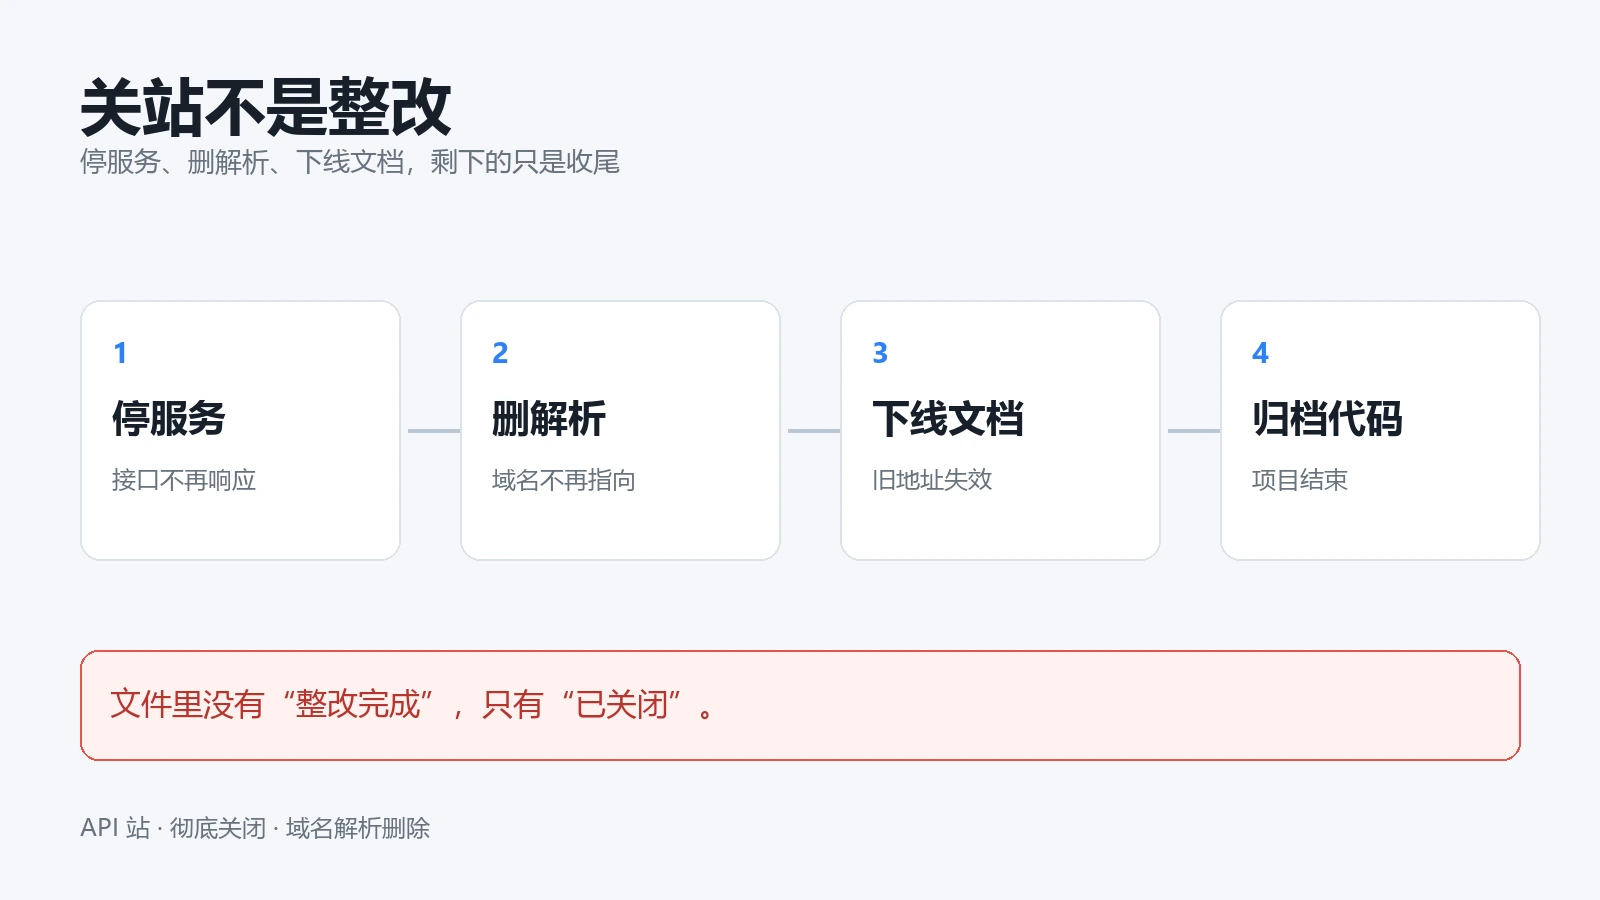
收尾示意:停服务、删解析、下线文档,和整改不是一回事。
9. 上线前的检查
下面这些问题,最好在写第一行代码之前问一遍:
| 问题 | 如果答不上来 |
|---|---|
| 数据从哪来 | 先别抓 |
| 有没有明确授权 | 先别上线 |
| 是否绕过登录、付费、验证码或反爬 | 停下来 |
| 是否包含个人信息 | 按会包含来处理 |
| 数据是否用于 AI 训练、检索或转售 | 写清楚用途和边界 |
| 是否遵守 robots、用户协议和 API 限额 | 逐条核对 |
| 能不能说清调用方和用途 | 说不清就先别开放 |
| 有没有下架、删除、更正机制 | 补上再谈上线 |
| 来源和授权记录能不能拿出来 | 拿不出来就等于没有 |
| 是否有评论、留言、投稿等交互入口 | 先关掉,或补审核 |
| AI 功能有没有说明用途和数据来源 | 写清楚再开放 |
| 域名解析是否已经删除 | 关闭前处理 |
这张表不复杂。复杂的是填“是”的时候,要能拿出证据。
10. 小结
站点彻底关了,代码还在。程序在 bocmiao/api,我把能公开的部分留下,把不该留的个人信息清掉,API 文档也下了线。
代码能跑,只说明它没报错;能不能上线,是另一套问题。
如果你正在做类似的项目,先把数据来源和授权写清楚。写不清楚,就别急着上线。
电话不会跟你讨论架构,它只给你一个结论。代码还在,解析没了。


